Assistant IA d’entreprise sur mesure, hébergé sur vos propres serveurs, sans fuite de données
Déposez Excel, PDF, images et notes dans la bibliothèque de documents, posez une question en une phrase, et l’assistant IA « OurServer AI » répond en s’appuyant sur ces documents. C’est un produit entièrement pris en charge en interne, de la conception au design, au développement et à l’exploitation, achevé en septembre 2026 avec une stack complète Next.js, MongoDB et un modèle de langage exploité en propre.
Vérification des sources des réponses
Avant
Les conditions contractuelles, les normes de qualité et les consignes d’inspection sont dispersées dans Excel, PDF, images et notes, et trouver une réponse prend du temps.
Après
Les réponses portent le nom du fichier et l’emplacement (feuille, numéro de section), pour une vérification immédiate.
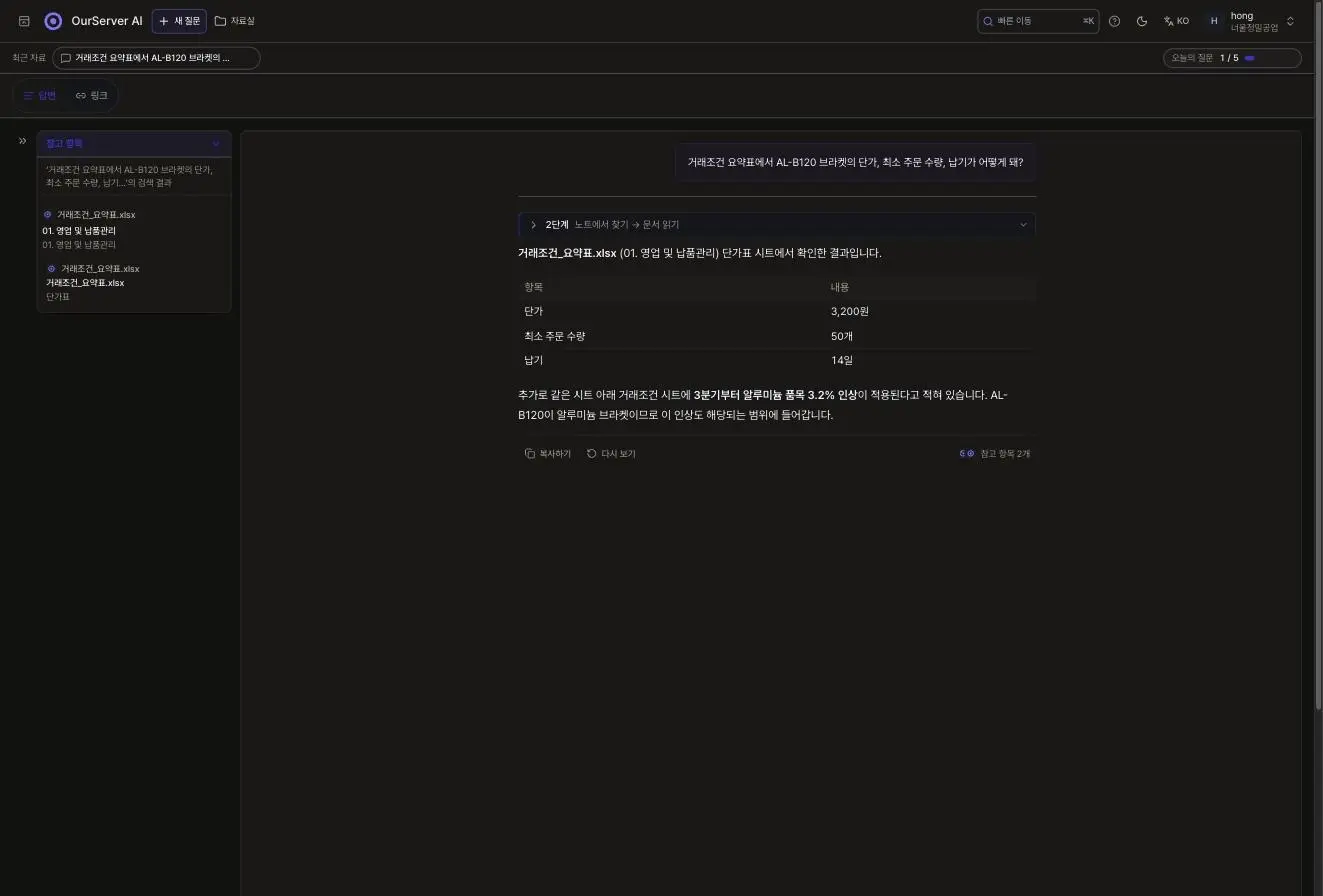
Le modèle qui produit les réponses
Le modèle de langage s’exécute sur des serveurs que nous exploitons nous-mêmes. Cette règle est imposée par un contrôle automatique exécuté à chaque build, et tout code appelant un modèle externe est bloqué dès l’étape de build.
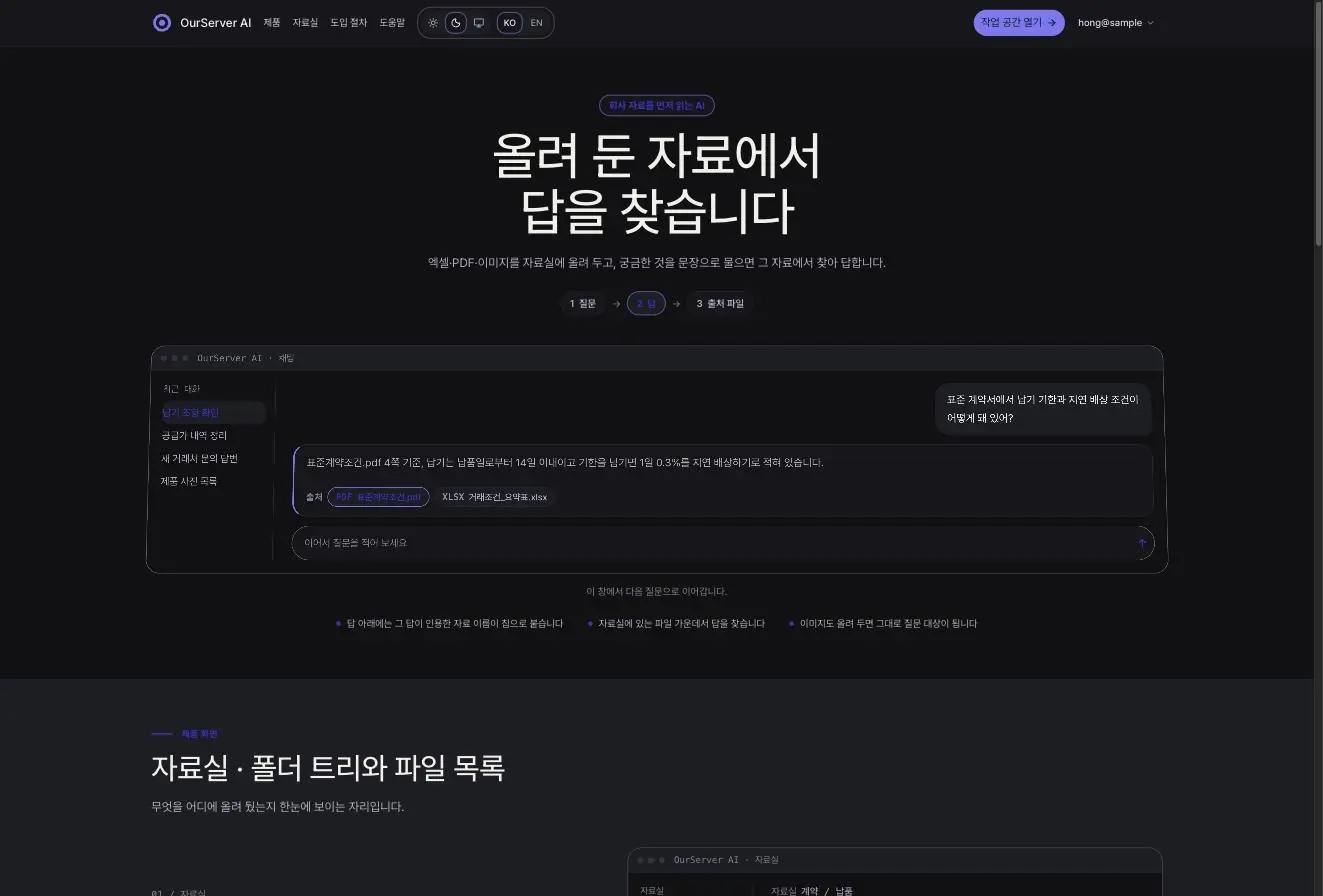 Écran d’accueil (landing) : « Trouver la réponse dans vos documents » et les trois étapes question → réponse → source
La source, cherchée puis jointe
Il lit Excel avec les feuilles et les cellules, PDF avec les numéros de section, ainsi que les images et les notes. Le nom du fichier et l’emplacement sont indiqués dans le corps de la réponse, et le panneau « Références » latéral affiche les fichiers et dossiers cités avec la mention « N références ». Au besoin, une recherche web apporte des informations à jour avec leurs sources web. La réponse est rédigée dans la langue de la question, et les conversations passées peuvent elles aussi être retrouvées par recherche.
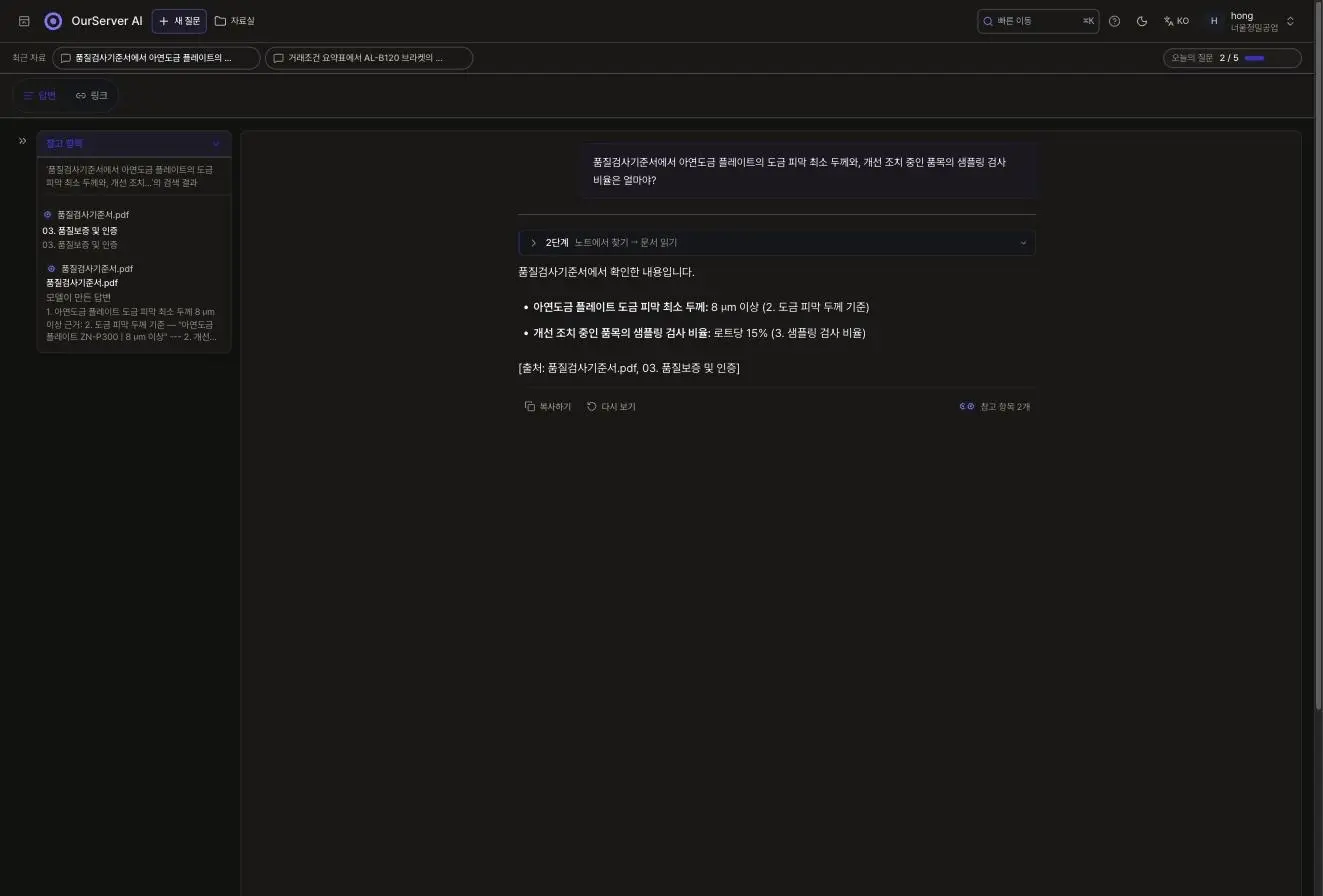 Réponse ayant trouvé 8 µm ou plus (section 2) et 15 % (section 3) dans 품질검사기준서.pdf
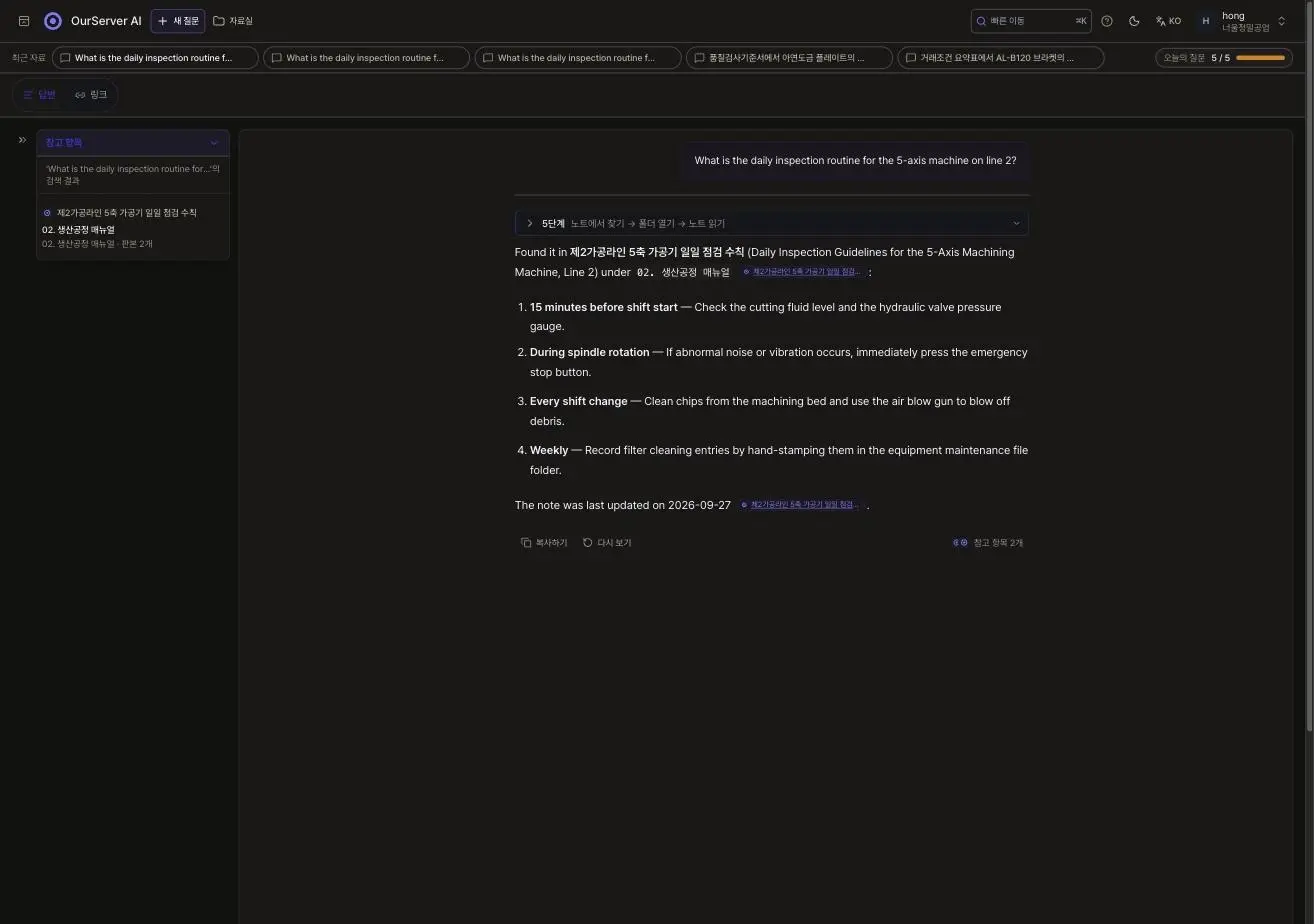 Question en anglais (inspection quotidienne d’une machine 5 axes), réponse en quatre étapes en anglais, source : note des consignes d’inspection
La bibliothèque de documents
Les documents sont organisés en arborescence de dossiers, avec vue liste et vue par cellules, aperçu des fichiers Excel, PDF et images, corbeille et éléments récents. Les contenus mémorisés par l’assistant sont enregistrés sous forme de notes, que l’on peut ouvrir pour les modifier ou les supprimer.
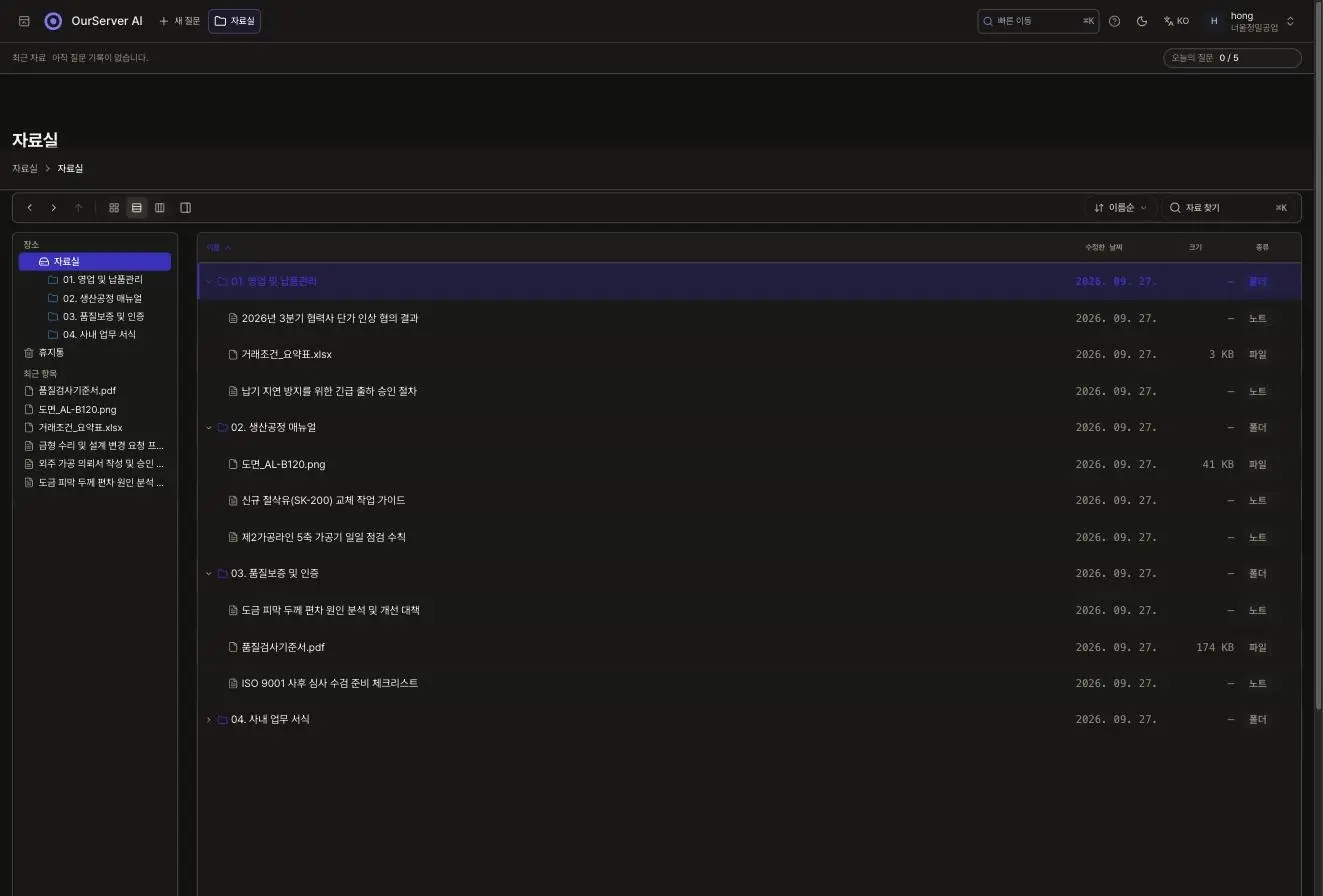 Vue liste de la bibliothèque : sous quatre dossiers, des notes, Excel, images et PDF, avec l’arborescence à gauche et corbeille · éléments récents
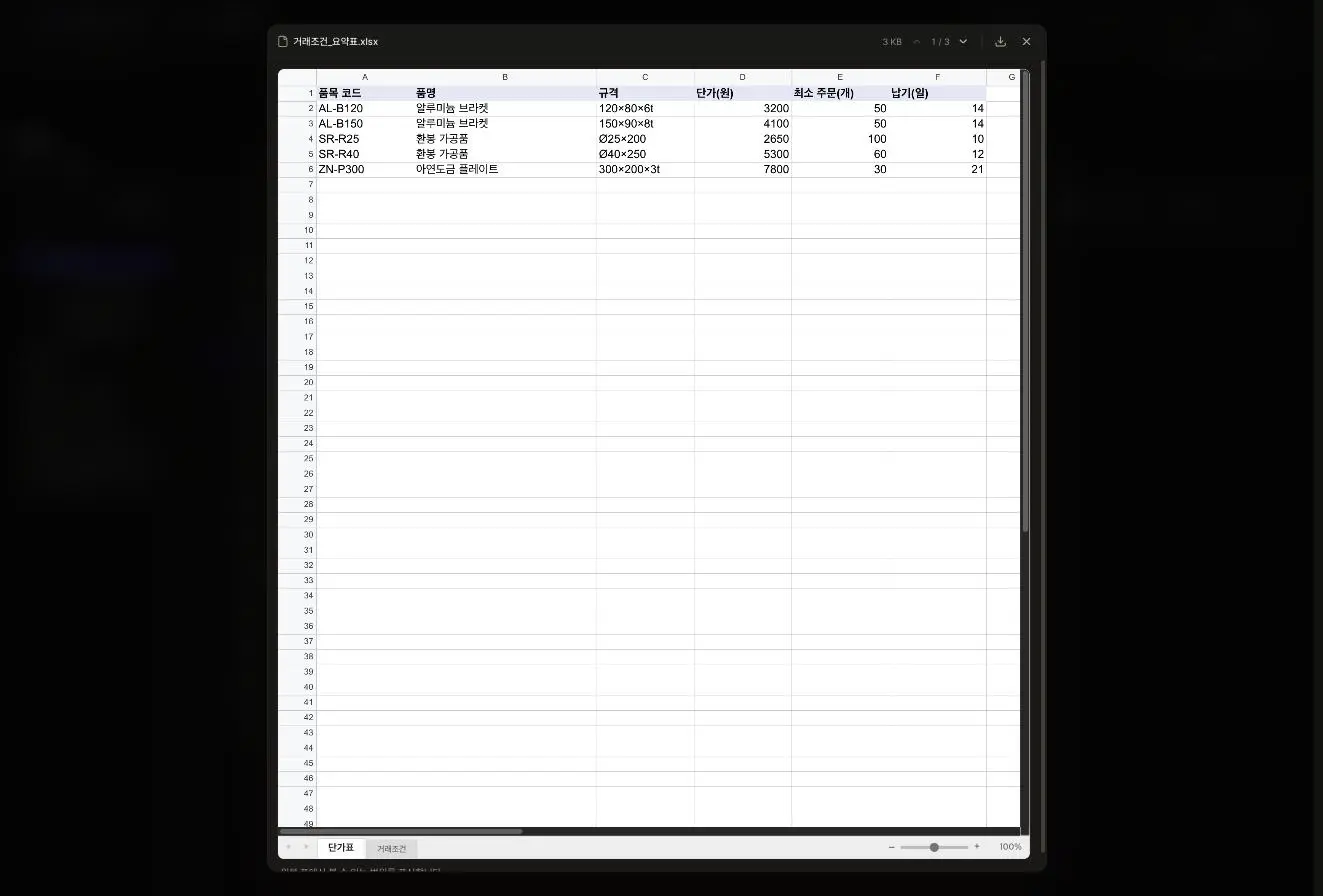 Aperçu Excel : feuille « Tableau des prix » de 거래조건_요약표.xlsx et onglets de feuilles en bas
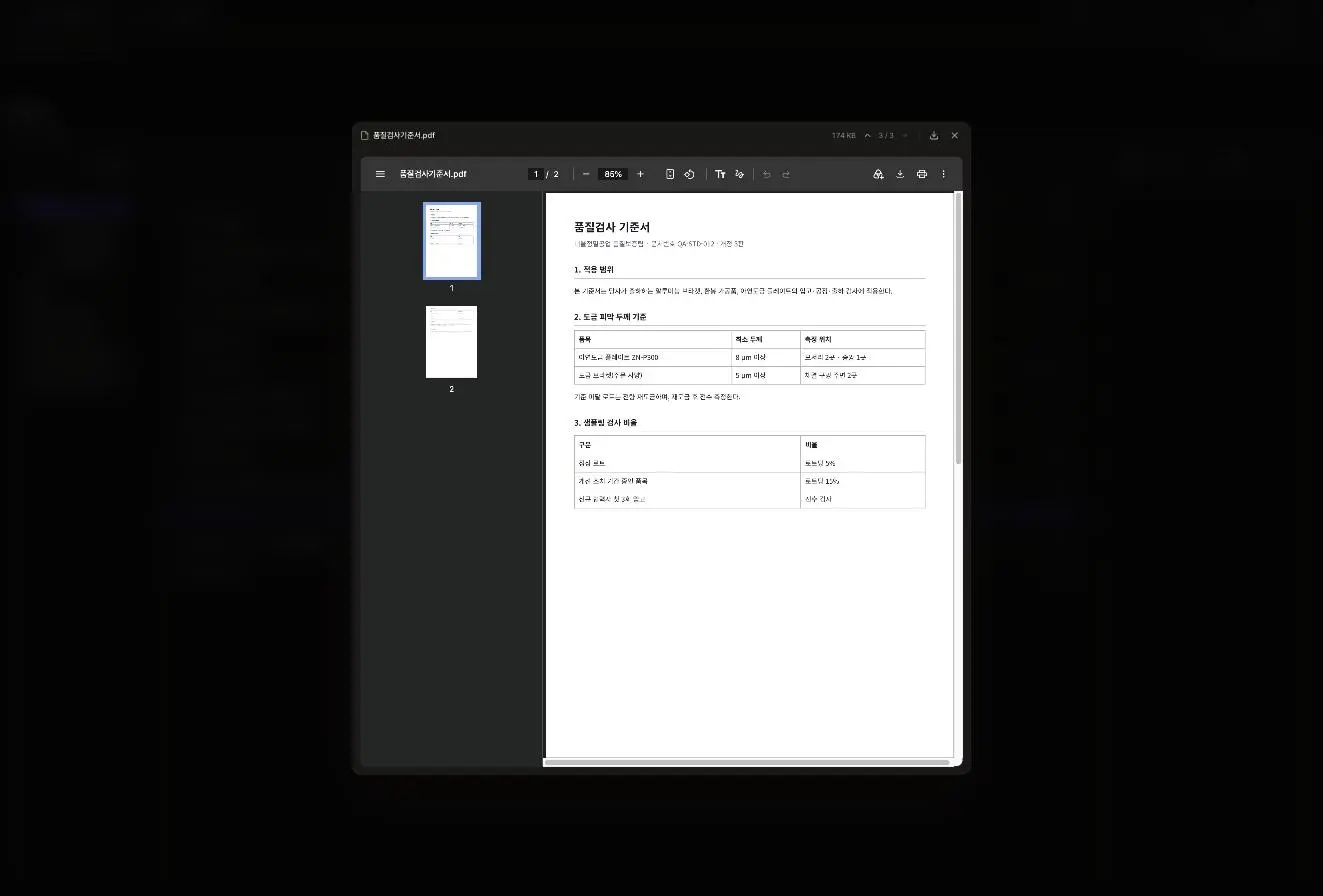 Aperçu PDF : 품질검사기준서.pdf, page 2
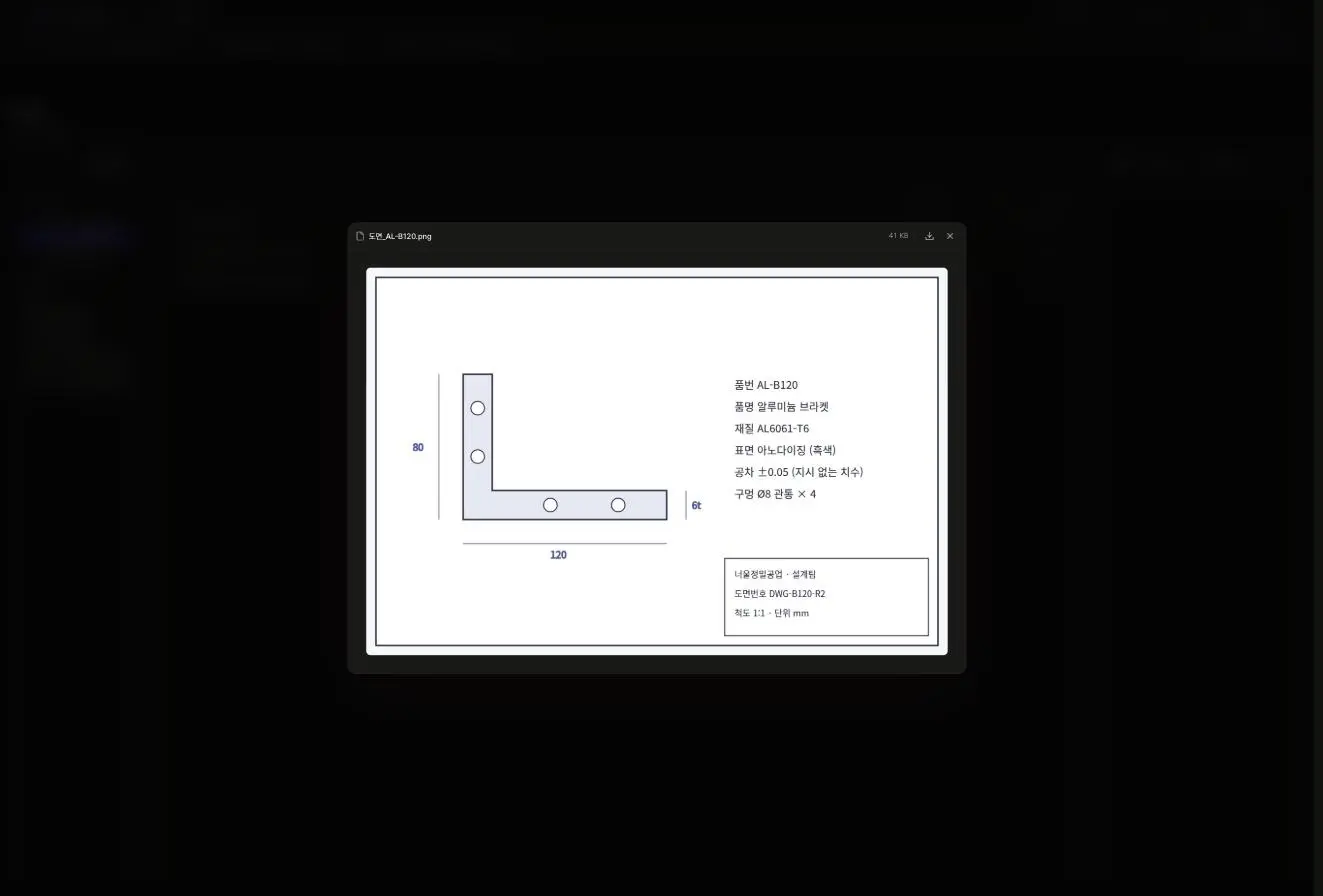 Aperçu d’image de la bibliothèque ouvert sur 도면_AL-B120.png
Équipes et exploitation
Les documents et les conversations sont séparés par espace de travail (équipe), et les rôles membre ou administrateur sont attribués par invitation par e-mail. Dans l’« Aperçu » du « Journal d’exploitation » de la console d’exploitation figurent la tendance d’exécution, les erreurs, les jetons et une valeur indicative de coût sur les 14 derniers jours ; dans « Historique d’utilisation », chaque exécution laisse le modèle, les étapes, les jetons d’entrée/sortie et la durée. « Questions du jour N / 5 » affiche la limite quotidienne de questions à l’écran, et la bascule coréen/anglais et clair/sombre ainsi que la connexion par e-mail vérifié après inscription sont proposés.
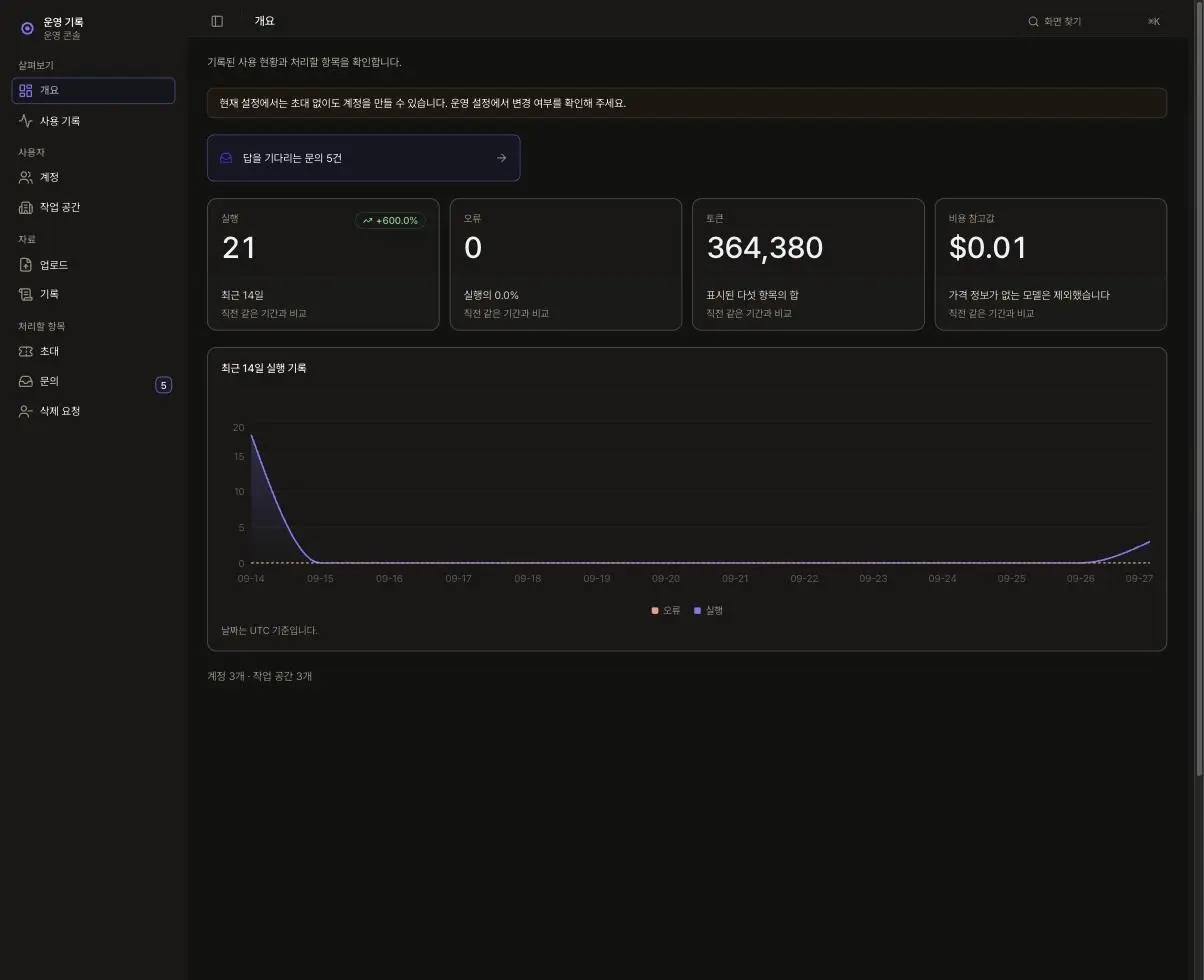 « Aperçu » du « Journal d’exploitation » : graphique des exécutions des 14 derniers jours et erreurs · jetons · coût indicatif
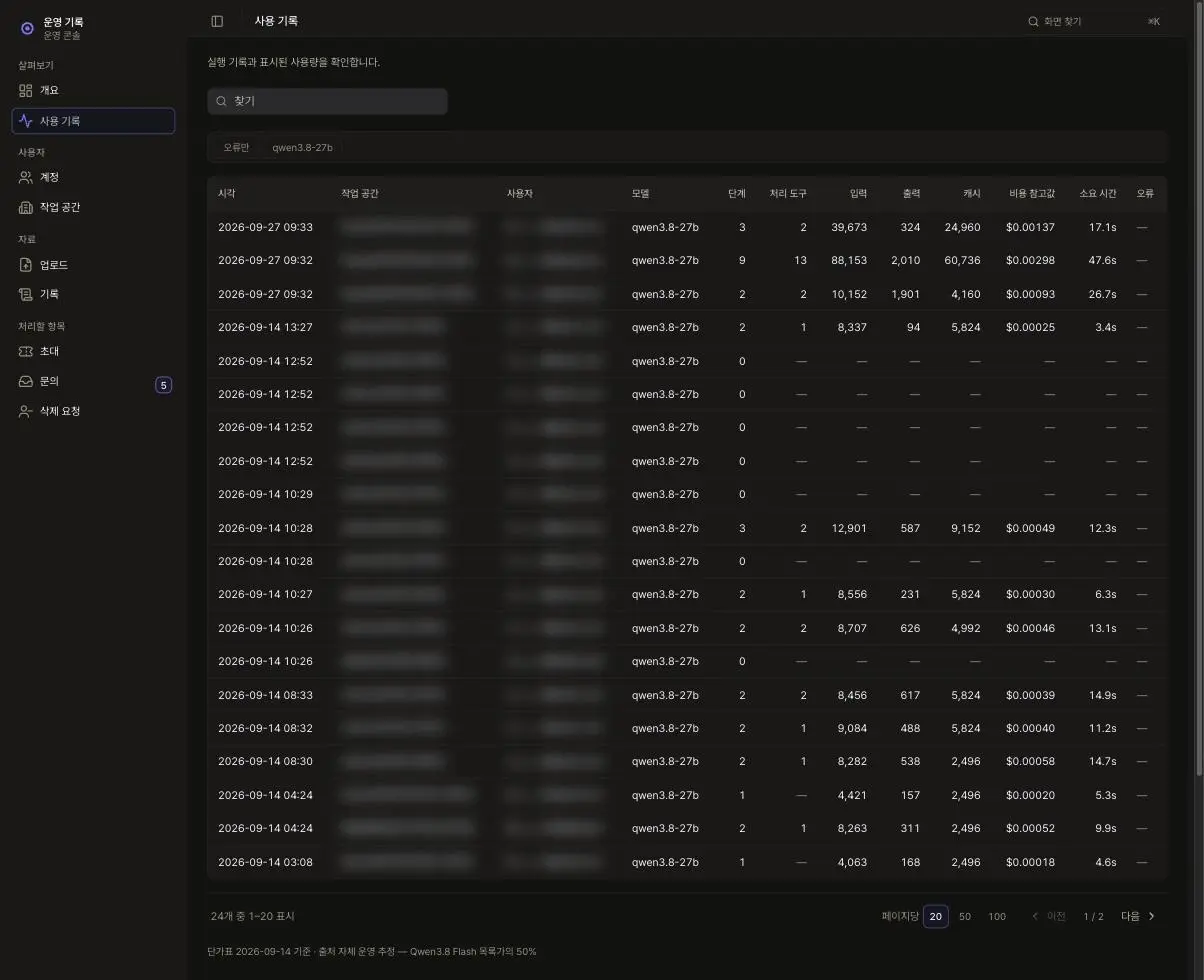 « Historique d’utilisation » : par exécution, modèle · étapes · jetons d’entrée/sortie/de cache · durée, colonnes d’identité floutées
Un déploiement différent selon le client
Les instructions qui définissent le rôle de l’assistant sont placées dans un seul endroit de la configuration de déploiement. En modifiant uniquement cette configuration, on le déploie en assistant d’un autre domaine, et en ne changeant que la configuration de build, on exploite deux marques distinctes avec des noms, des images d’aperçu de lien et des e-mails d’envoi différents.
Exemples de réponses
À la question « prix unitaire, quantité minimale de commande et délai de livraison du support AL-B120 dans le tableau récapitulatif des conditions commerciales », la réponse est un tableau (prix unitaire 3 200 won · commande minimale 50 pièces · délai de livraison 14 jours). Elle mentionne aussi l’augmentation de 3,2 % au troisième trimestre figurant dans la feuille des conditions commerciales. À la question « épaisseur minimale du revêtement et taux de contrôle par échantillonnage des plaques galvanisées dans 품질검사기준서.pdf », elle trouve 8 µm ou plus (section 2) et 15 % (section 3) et indique le nom du fichier et le numéro de section. Les sociétés, articles et chiffres visibles à l’écran sont des données de démonstration.
Contexte du projet
- Problème
- Les conditions contractuelles, les normes de qualité et les consignes d’inspection sont dispersées dans Excel, PDF, images et notes, et trouver une réponse prend du temps.
- Les documents sont souvent envoyés à des services d’IA externes pour obtenir des réponses ; il fallait donc une manière de les traiter sur nos propres serveurs.
- Objectifs du projet
- Créer une bibliothèque de documents centralisant tout, de sorte qu’une question formulée en une phrase renvoie la réponse et sa source à partir de ces documents.
- Répondre dans la langue de la question et permettre de retrouver les conversations passées.
- Points clés
- L’utilisateur aussi peut voir immédiatement le nom du fichier et l’emplacement (feuille, numéro de section) et vérifier la réponse.
- Les documents et conversations sont séparés par espace de travail, et le détail des exécutions est consultable dans l’écran d’exploitation « Journal d’exploitation ».
Résultats
Une architecture dont les réponses viennent d’un modèle de langage exploité en propre Le modèle qui produit les réponses est hébergé sur des serveurs que nous exploitons nous-mêmes, et cette règle est garantie par un contrôle automatique exécuté à chaque build. Nous avons conçu ensemble la procédure de vérification et l’écran d’exploitation « Journal d’exploitation ».
Des réponses puisées dans la bibliothèque de documents avec leurs sources Il lit Excel, PDF, images et notes et joint à la réponse le nom du fichier ainsi que la feuille ou le numéro de section. Le panneau « Références », les aperçus, la corbeille et l’invitation d’équipe ont été conçus dans un seul et même parcours d’écran.
Fonctionnalités clés
Serveurs privés avec protection contre les fuites de données Déploiement du modèle d’IA dans un environnement on-premise ou sur serveur dédié afin d’empêcher les données internes de sortir et de garantir la sécurité.
Recherche contextuelle dans les documents internes avec mention des sources Analyse des feuilles et cellules Excel, des numéros de section PDF, des images et des notes afin de fournir des réponses incluant le nom du fichier et l’emplacement précis.
Panneau des références et aperçu des documents Visualisation immédiate dans un panneau latéral des documents et dossiers servant de base, et facilitation de la vérification grâce aux aperçus Excel/PDF.
Isolement de la sécurité par équipe et gestion des droits Séparation stricte des documents et de l’historique des conversations par espace de travail, avec attribution des droits par invitation par e-mail.
Console de journal d’exploitation transparente Vue d’ensemble de l’état d’exploitation : tendance d’utilisation sur 14 jours, erreurs, jetons et coût indicatif, durée d’exécution.
Étapes du projet
- Conception — Définition des règles de citation des sources dans les réponses et de la structure de la bibliothèque, puis fixation des noms d’écrans et des parcours.
- Design — Conception des écrans de chat, de la bibliothèque et de la console d’exploitation « Journal d’exploitation », avec les versions coréen/anglais et clair/sombre.
- Développement — Ajout d’un modèle de langage exploité en propre par-dessus une stack complète Next.js et MongoDB, avec séparation des rôles et des marques pilotée par la configuration de déploiement.
- Vérification et exploitation — Mise en place de la connexion par e-mail vérifié après inscription, de la limite quotidienne de questions par espace de travail, et des contrôles via l’écran de journal d’exploitation.
Nos autres produits que nous avons créés et que nous exploitons nous-mêmes sont regroupés sur la page produits maison.