

Collecteur unifié d'avis produits internationaux
Pour une société internationale d'études de marché, nous avons collecté les avis produits de douze sources, grandes plateformes de distribution d'Amérique du Nord et d'Amérique latine et boutiques en ligne de marques d'électroménager. Chaque plateforme fournissant ses données différemment, nous avons adapté la collecte à chacune plutôt que d'imposer un collecteur unique, puis réuni le tout dans un tableau au format commun.
Obtention des données d'avis
Avant
Collecte séparée, selon une méthode propre à chaque plateforme
Après
Douze sources réunies dans un seul tableau au format commun
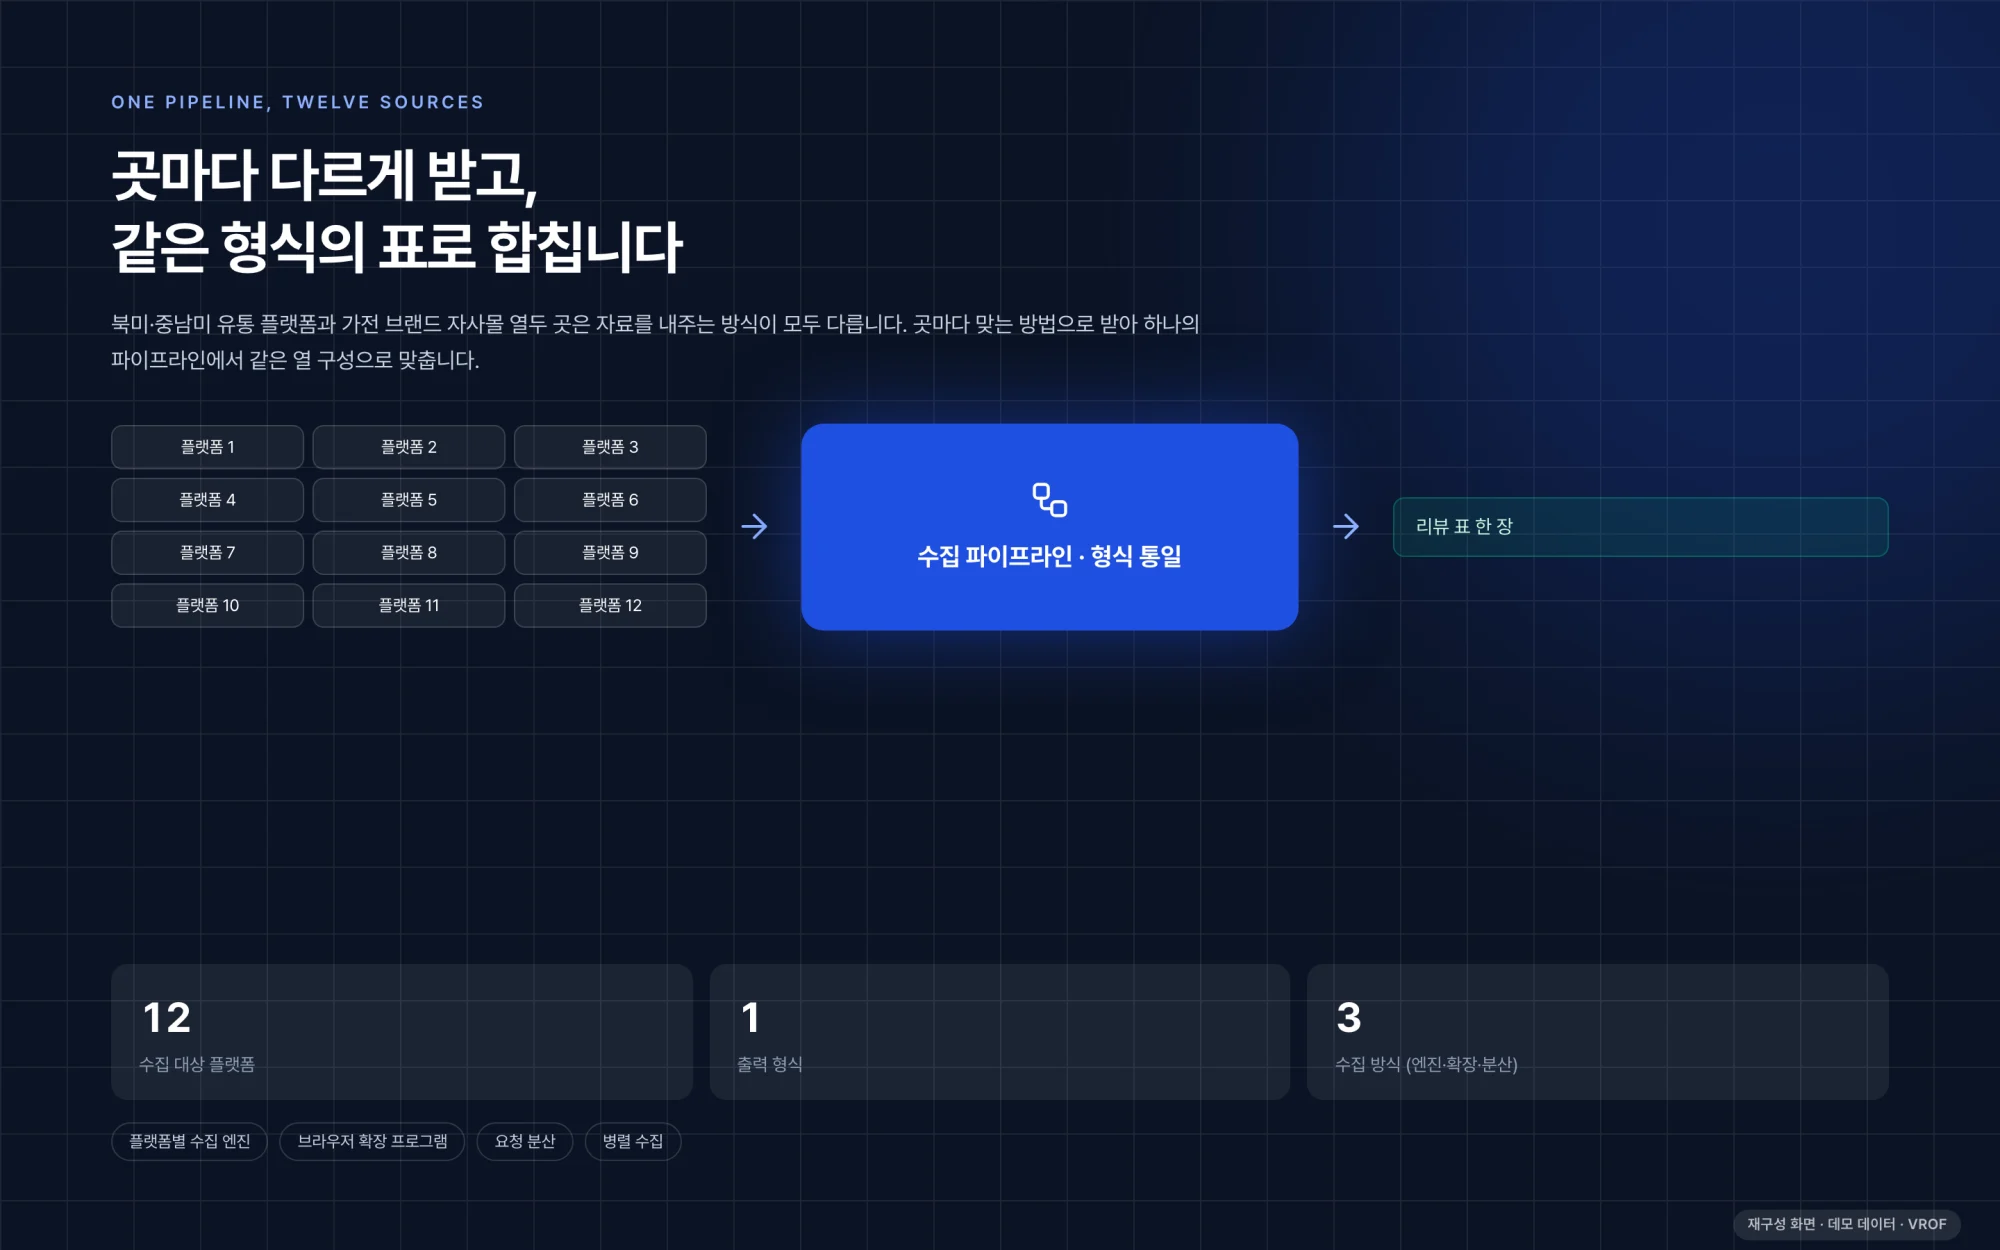
Les écrans sont reconstitués avec des données fictives pour protéger les informations clients.
Contexte
En études de marché, les avis produits sont une donnée de base. Or la plupart se trouvent sur de grandes plateformes de distribution dont les conditions d’accès sont les plus strictes. Même avec un plan d’étude abouti, les projets butaient régulièrement sur l’obtention des données.
Ce que nous avons constaté
Chaque plateforme fournissait ses données à sa manière. Certaines sont sensibles à l’intervalle entre les requêtes, d’autres répondent différemment selon l’environnement de connexion, d’autres encore servent les avis par une API distincte. Un collecteur unique pour toutes ne fonctionne de manière stable sur aucune.
Le problème
Nous avons choisi une méthode d’accès propre à chaque plateforme, tout en mettant en commun le nettoyage, la fusion et la sortie. L’interruption d’une collecte relève de chaque plateforme ; des formats de résultats disparates posent un problème pour l’ensemble.
Ce que nous avons réalisé
- Moteurs de collecte par plateforme — pour les grandes plateformes de distribution des États-Unis et du Brésil et les boutiques en ligne de marques d’électroménager, chaque moteur est adapté à la manière dont le site fournit ses données
- Des valeurs fiables même si l’interface change — pour certaines plateformes, une extension Chrome lit directement les données internes déjà chargées par la page, plutôt que son affichage
- Répartition des requêtes et collecte parallèle à 3 niveaux — les requêtes ne partent pas en masse d’un seul point, mais empruntent plusieurs voies. La conception est documentée pour être reproductible
- Sortie unique — quelle que soit la plateforme, les données sont restituées dans un tableau au même format
Précautions prises
Les incidents qui surviennent réellement lors de collectes de plusieurs jours sont traités dans le code, et leur bon fonctionnement a été confirmé par 26 vérifications.
- Reprise après interruption — la collecte reprend au plus petit des deux repères : le point de progression enregistré ou le nombre de données effectivement accumulées. Récupérer des doublons coûte moins cher que découvrir des lacunes après coup
- Dédoublonnage lors de la fusion — les données sont fusionnées par identifiant unique. Celles déjà reçues restent intactes
- Changement de voie — en l’absence de réponse ou si la réponse est mal formée, la collecte bascule sur une autre voie et reprend au même point
- Les données mal formées n’entrent pas dans le tableau — toute valeur qui ne correspond pas au format attendu est écartée immédiatement
- Limitation automatique du parallélisme — si la valeur demandée est excessive, l’outil la réduit de lui-même. C’est en évitant les requêtes en rafale qu’une collecte de plusieurs jours va jusqu’à son terme
Résultats
Même avec douze plateformes, le résultat tient dans un seul tableau au format commun. Les colonnes ne varient pas selon la source, si bien que les données s’utilisent telles quelles pour l’analyse, sans étape de remise en forme. L’ajout d’une source se limite à sa méthode d’accès ; le nettoyage, la fusion et la sortie restent inchangés.
Nos autres réalisations fondées sur la même approche sont réunies dans Collecte de données web.