

Collecteur de projets d'investissement en Inde
Nous avons collecté l'ensemble des projets publiés sur le portail gouvernemental qui recense les projets d'investissement de toute l'Inde, et réuni leurs informations détaillées, jusque-là dispersées, dans un tableau unique de 41 champs. L'outil a été livré sous forme d'exécutable, directement utilisable par les équipes.
Projets collectés
Avant
Consultation projet par projet
Après
19 889 projets · 41 champs
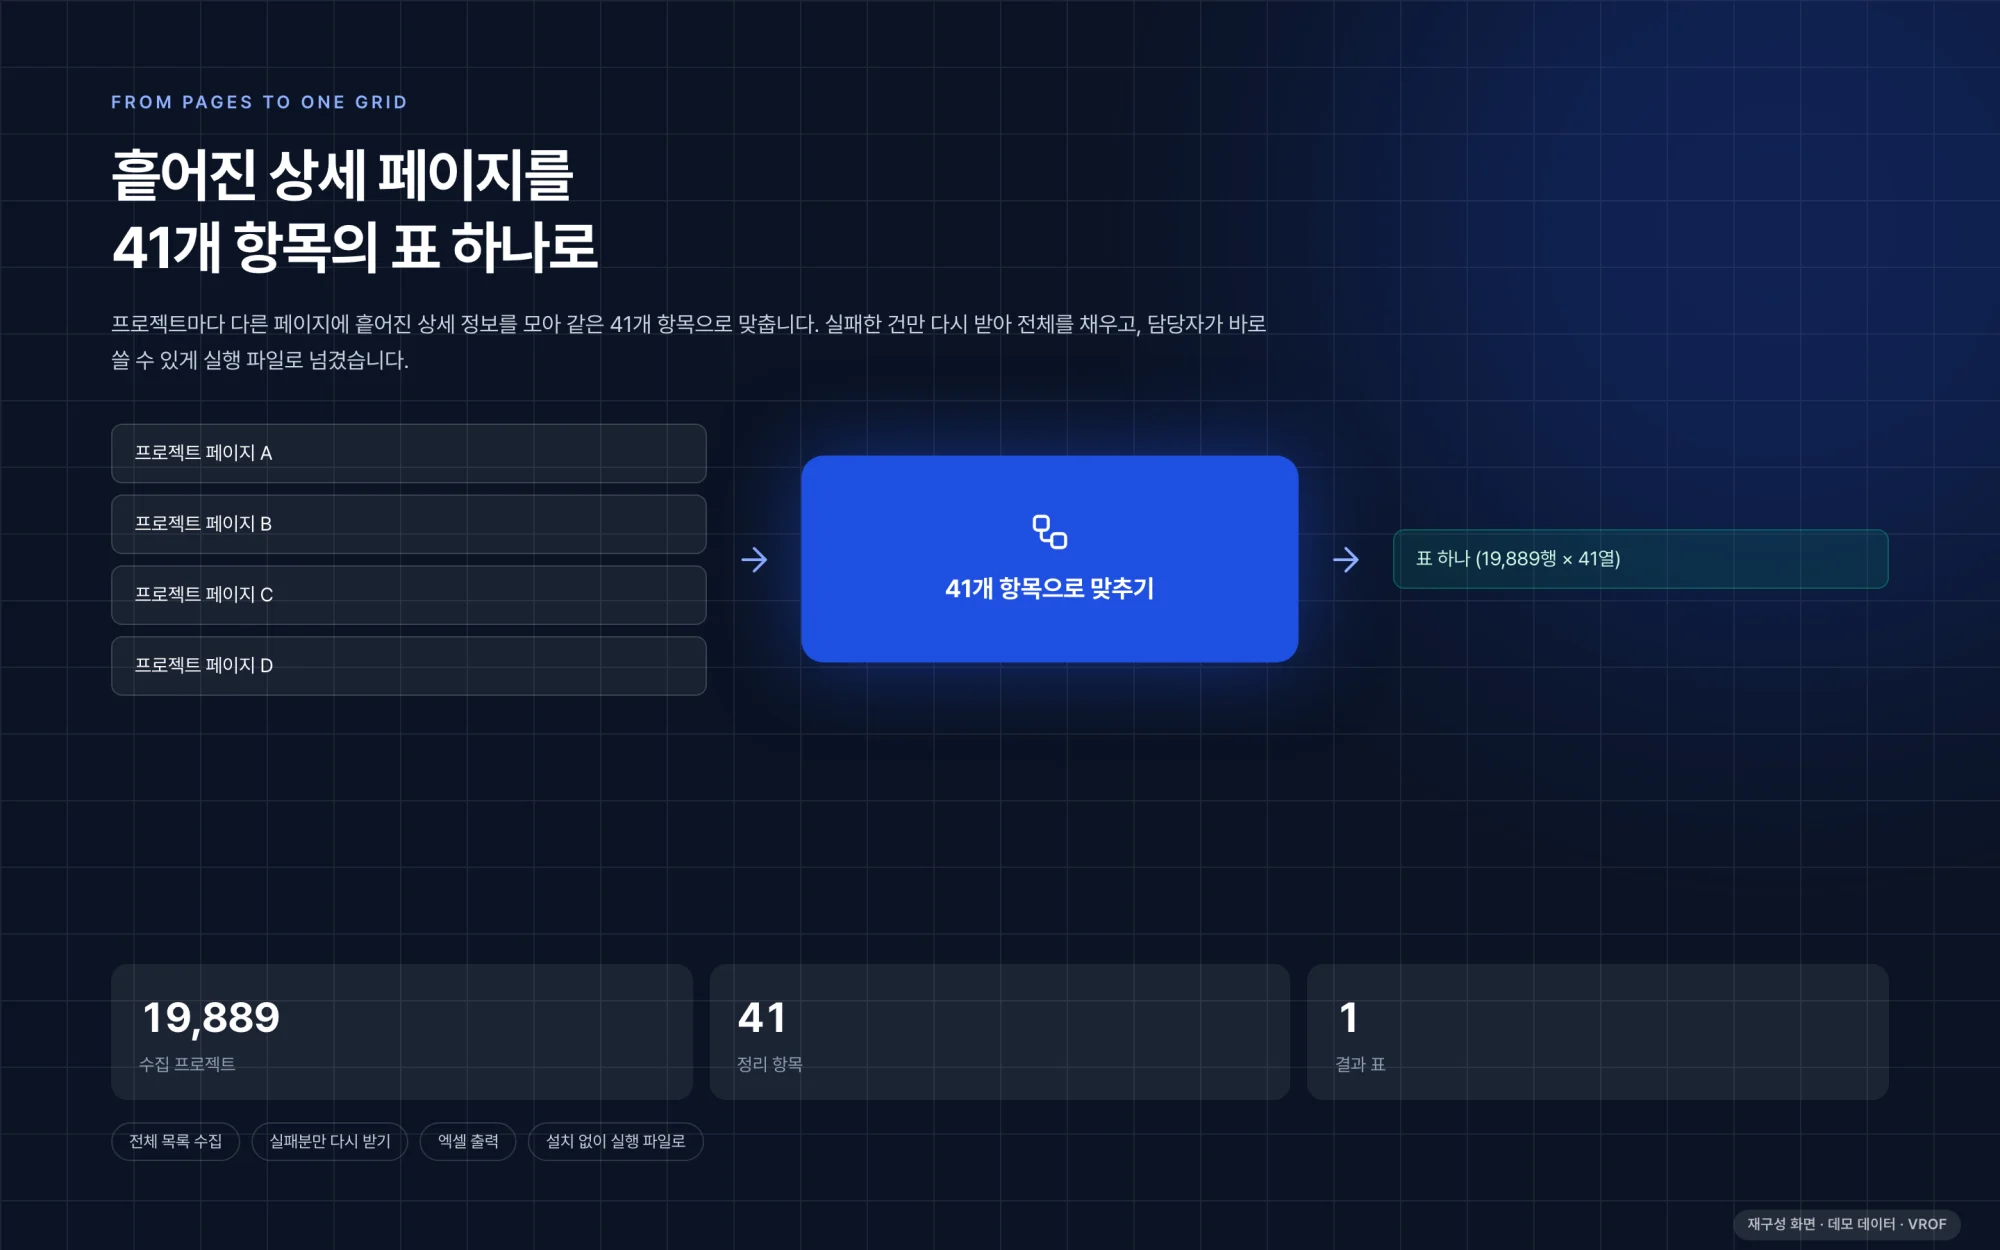
Les écrans sont reconstitués avec des données fictives pour protéger les informations clients.
Contexte
Les informations sur les projets d’investissement en Inde sont publiées sur India Investment Grid, portail géré par le gouvernement. Mais chaque projet dispose de sa propre page. Pour savoir quels montants étaient engagés, dans quel secteur et dans quel État, il fallait ouvrir les pages une à une.
Ce que nous avons constaté
La recherche ne portait pas sur tel ou tel projet, mais sur la répartition d’ensemble. Or le portail est conçu pour une consultation au cas par cas : pour analyser les projets par secteur ou par stade, il aurait d’abord fallu tout recopier à la main. Vu le nombre de projets, ce travail n’était même pas envisageable.
Le problème
La difficulté tenait moins à la collecte qu’à l’harmonisation des champs. Les champs renseignés variaient selon les projets, les budgets mélangeaient devises et unités, et des valeurs de même sens figuraient sous des intitulés différents. Ces écarts devaient être résolus avant de pouvoir constituer un tableau unique.
Ce que nous avons réalisé
- Collecte de l’ensemble des projets — les projets des 41 secteurs ont été collectés sans omission
- Normalisation en 41 champs — secteur, sous-secteur, stade du projet, budget total, État, mode de réalisation, type de projet, date d’achèvement prévue, etc. : les valeurs dispersées sont alignées dans les mêmes colonnes
- Livraison sous forme d’exécutable — les équipes peuvent le lancer sans environnement Python
Précautions prises
Sur un tel volume, une partie des requêtes échoue inévitablement. La question n’est pas d’éviter tout échec, mais de pouvoir retrouver ensuite ce qui a échoué.
- Les adresses en échec sont enregistrées à part — en cas de coupure ou d’absence de réponse, l’adresse est consignée dans un fichier distinct, et la collecte se poursuit
- Un script dédié ne récupère que cette liste — inutile de tout relancer depuis le début. La seconde collecte ne porte que sur les échecs
- Les résultats récupérés sont archivés et datés — on sait ce qui a été complété, et quand
- 12 requêtes simultanées, chacune avec un délai maximal — une requête sans réponse ne bloque pas l’ensemble
Résultats
19 889 projets ont été organisés en 41 champs. Parmi eux, 19 087 comportent un budget total renseigné.
Par secteur, les routes et autoroutes arrivent en tête avec 4 180 projets, devant l’eau, l’assainissement et les déchets (2 264), l’immobilier (1 480), la santé (1 271), l’éducation (954) et le ferroviaire (920). Les projets se répartissent en 5 stades, dont en développement, en cours de réalisation et achevé.
Nos autres réalisations fondées sur la même approche sont réunies dans Collecte de données web.